Table des matières
Un tracking server-side ne reste pas fiable tout seul. Une mise à jour du site, un réglage de la bannière cookies ou un changement côté plateforme suffit à couper une partie des conversions, souvent sans aucun message d'erreur. La réponse tient en trois niveaux de surveillance : des alertes automatiques sur les volumes d'événements, une revue hebdomadaire des logs du serveur, et un audit complet toutes les six à huit semaines.
Cet article s'adresse aux PME suisses, aux agences web et aux agences marketing qui ont déjà investi dans un conteneur Google Tag Manager server-side (sGTM) et qui veulent que cet investissement produise des données justes sur la durée, pas seulement le jour de la mise en ligne.
L'essentiel
Un hébergeur sGTM surveille son infrastructure, pas votre configuration : si votre site cesse d'envoyer des événements, le serveur reste « en bonne santé » et ne vous dit rien.
Les pannes les plus fréquentes viennent de votre propre site : déploiement, changement de thème, refonte du tunnel de commande, modification de la CMP.
Une alerte simple sur un volume minimum d'événements par heure détecte la plupart des coupures totales en moins d'une heure.
La revue des logs doit être hebdomadaire, car leur durée de conservation est courte (quelques jours selon l'offre).
La surveillance est aussi un sujet de conformité : un tag qui se déclenche avant le consentement après une mise à jour contredit ce que votre politique annonce, et l'art. 7 LPD impose une protection des données dès la conception et par défaut.
Pourquoi un tracking server-side qui fonctionnait peut-il casser sans prévenir ?
Le server-side déplace la collecte vers un serveur que vous contrôlez. C'est un progrès majeur, que nous avons détaillé dans notre article sur la maîtrise de votre donnée en Suisse. Mais le serveur ne reçoit que ce que le navigateur lui envoie. Tant que votre site, votre CMP et vos balises web évoluent, la chaîne peut se rompre en amont du serveur.
Dans un article publié le 2 septembre 2026, l'équipe de Stape résume le problème ainsi : le tracking server-side « ne reste pas réparé ». Nous voyons les mêmes causes revenir dans nos audits en Suisse romande et alémanique.
Les déploiements du site web
C'est la cause numéro un. Un développeur livre une nouvelle version du site et, sans le vouloir, modifie un élément dont dépend le tracking :
le snippet GTM retiré d'un gabarit de page, par exemple la page de confirmation de commande ;
le paramètre qui envoie les requêtes GA4 vers votre sous-domaine de collecte supprimé de la balise Google ;
une classe CSS ou un identifiant de bouton renommé, alors qu'un déclencheur GTM s'appuyait dessus ;
un tunnel de commande reconstruit, avec un dataLayer qui ne pousse plus l'événement purchase ou qui le pousse sans valeur.
Dans les trois derniers cas, le tracking ne s'arrête pas entièrement. Il perd un morceau. Les pages vues continuent d'arriver, les tableaux de bord semblent normaux, et seules les conversions disparaissent. C'est la panne la plus coûteuse, parce que Smart Bidding et les algorithmes de Meta continuent d'optimiser sur un signal devenu faux.
La CMP et le consentement
La bannière cookies est un composant vivant : mises à jour de l'éditeur, nouveaux textes, nouvelles catégories, changement de prestataire. Chaque modification peut perturber deux mécanismes essentiels.
Le premier est l'ordre d'exécution. La documentation de Google sur le Consent Mode est explicite : si le code de consentement est appelé dans le désordre, les valeurs par défaut ne fonctionnent pas. L'état par défaut doit être défini avant le chargement des balises Google, puis mis à jour par la commande update dès que l'utilisateur fait un choix.
Le second est l'événement de mise à jour. Toutes les CMP ne poussent pas un événement distinct dans le dataLayer quand l'utilisateur change ses préférences. Stape a publié le 9 septembre 2026 un guide sur ce cas précis : les balises Google compatibles avec le Consent Mode s'adaptent seules, mais les balises tierces (LinkedIn, TikTok, Microsoft Ads, outils CRM) ne peuvent pas réagir si aucun événement ne leur indique que le consentement a changé. Résultat : des conversions perdues, ou pire, des balises déclenchées au mauvais moment.
Si votre Consent Mode vous semble encore flou, commencez par notre guide Google Consent Mode v2.
Les changements côté plateformes et navigateurs
Meta, Google, LinkedIn ou Apple modifient régulièrement leurs API, leurs exigences de paramètres et le comportement des navigateurs. Votre configuration n'a pas bougé, mais ce qu'elle produit a changé. Une version de modèle de balise qui n'est plus maintenue, un paramètre devenu obligatoire, un format d'identifiant modifié : ces changements ne génèrent pas toujours d'erreur visible, seulement une baisse du taux de correspondance ou des conversions attribuées.
La dérive de configuration
Enfin, il y a l'usure. Au fil des mois, plusieurs personnes interviennent dans le conteneur : l'agence Ads ajoute une balise, un stagiaire duplique un déclencheur, un prestataire teste une intégration et oublie de la supprimer. Sans documentation ni revue régulière, le conteneur devient difficile à lire, et chaque panne met plus de temps à être diagnostiquée.
Infrastructure managée ou mesure surveillée : quelle différence ?
C'est le malentendu le plus fréquent chez nos clients. Beaucoup pensent qu'un hébergement managé (Stape, un autre prestataire, ou Google Cloud Run correctement configuré) couvre aussi la qualité des données. Ce n'est pas le cas. Voici ce que chacun surveille réellement.
Ce que surveille l'hébergeur : disponibilité du serveur, montée en charge, certificats, temps de réponse, mises à jour de l'image du conteneur. Stape indique par exemple qu'une équipe dédiée surveille son infrastructure en continu.
Ce que personne ne surveille à votre place : le volume d'événements envoyés par votre site, la présence des conversions, la cohérence des valeurs de commande, le respect du consentement, les erreurs renvoyées par Meta, Google Ads ou LinkedIn, la déduplication entre pixel et API.
Le signal d'alerte typique : côté hébergeur, tout est vert. Côté marketing, le coût par acquisition grimpe depuis dix jours et personne ne sait pourquoi.
Autrement dit, un serveur en parfaite santé peut très bien recevoir zéro achat. La surveillance de la mesure est une tâche distincte, qui doit avoir un responsable nommé.
Quels signaux surveiller en priorité ?
Inutile de tout surveiller. Six indicateurs couvrent l'essentiel des pannes que nous rencontrons.
Le volume d'événements entrants par heure. Une chute brutale des requêtes GA4 ou des page views reçues par le serveur signale une coupure totale : snippet retiré, domaine de collecte mal configuré, CMP bloquante.
Les erreurs serveur (5xx) et les pics d'erreurs client (4xx). Les 5xx sont prioritaires : le serveur n'a pas pu traiter la requête. Un pic de 4xx indique souvent une requête mal formée ou refusée par une plateforme.
Le taux de succès par destination. Meta, Google Ads, GA4, LinkedIn : chaque destination doit accepter la très grande majorité des requêtes sortantes. Une destination qui décroche seule pointe vers un problème de jeton, de paramètre ou de modèle de balise.
Le nombre de conversions clés par jour. Achats, leads, demandes de rendez-vous : comparez chaque jour au même jour de la semaine précédente. Une conversion qui tombe à zéro alors que le trafic est stable est le symptôme classique d'une panne partielle.
La cohérence avec la source de vérité. Une fois par semaine, rapprochez les commandes mesurées des commandes réelles de votre boutique ou de votre CRM. L'écart doit rester stable ; c'est sa variation qui compte.
Le comportement du consentement. Part des visiteurs qui acceptent, refusent ou ne choisissent pas, et absence de requêtes publicitaires avant consentement là où votre politique le promet.
Comment organiser la surveillance au quotidien ?
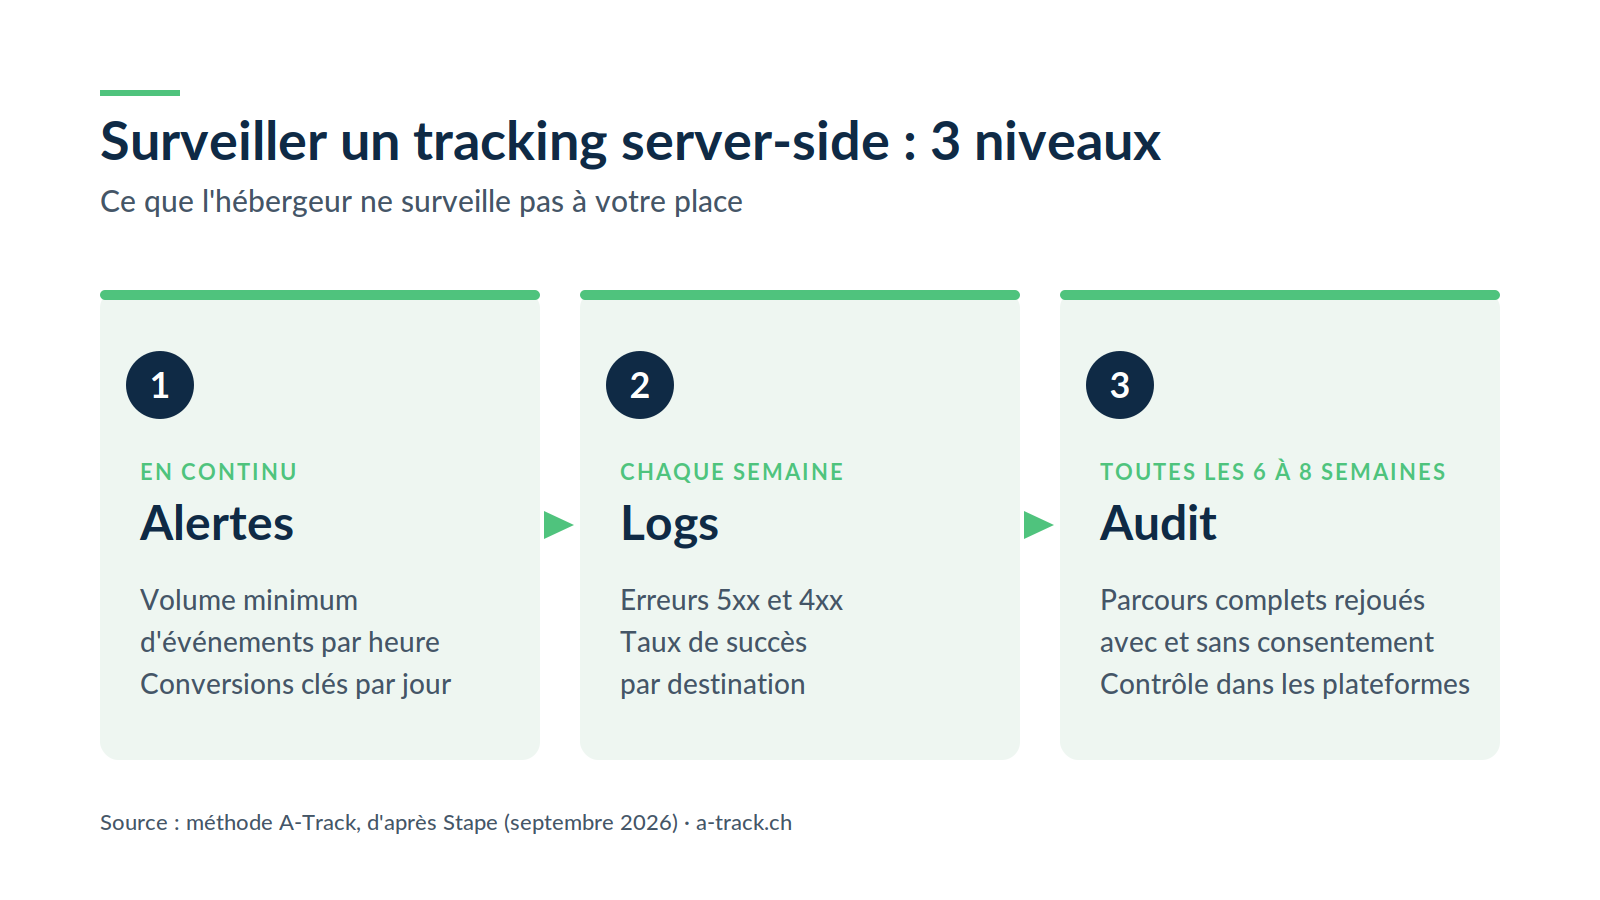
En continu : les alertes. Un volume minimum d'événements par heure et un suivi quotidien des conversions principales.
Chaque semaine : les logs. Erreurs 5xx et 4xx, taux de succès par destination.
Toutes les six à huit semaines : l'audit. Parcours complets rejoués, avec et sans consentement.
La méthode que nous appliquons chez nos clients reprend les trois niveaux décrits par Stape dans son guide post-lancement, adaptés aux volumes des PME suisses.
Niveau 1 : des alertes automatiques sur les volumes
Le principe est simple : définir un seuil minimum d'événements par heure et recevoir une alerte quand il n'est pas atteint. Dans son guide, l'auteure décrit une alerte déclenchée sous le seuil de dix page views par heure, qui l'a prévenue dans l'heure après un déploiement ayant cassé le tracking.
Le point clé est le calibrage. Le seuil doit être fixé à partir de vos heures les plus creuses, pas de votre moyenne. Un site B2B romand qui reçoit très peu de visites la nuit déclenchera de fausses alertes s'il applique le même seuil qu'un e-commerce national. Nous recommandons :
une alerte « coupure totale » sur les événements entrants, calée sur l'heure la plus creuse de la semaine ;
une alerte par destination critique (Google Ads, Meta, GA4) sur le taux de succès des requêtes sortantes ;
une alerte quotidienne sur les conversions principales, comparées au même jour de la semaine précédente.
Niveau 2 : une revue hebdomadaire des logs
Cinq à dix minutes par semaine suffisent. On parcourt les requêtes entrantes et sortantes, on cherche en priorité les erreurs 5xx, puis les pics de 4xx, et on vérifie que chaque destination accepte les requêtes.
Le rythme hebdomadaire n'est pas arbitraire. Chez Stape, les logs sont conservés 3 jours sur l'offre Pro et 10 jours sur les offres Business et Enterprise. Si vous regardez une fois par mois, vous ne verrez jamais la panne qui a eu lieu trois semaines plus tôt. Sur Google Cloud Run, la logique est la même : les logs existent, encore faut-il les consulter et définir des alertes.
Niveau 3 : un audit complet toutes les six à huit semaines
C'est la cadence recommandée dans le guide de Stape pour la maintenance manuelle. L'audit consiste à rejouer les parcours critiques en mode aperçu, dans le conteneur web et dans le conteneur serveur :
parcours d'achat ou de demande de contact complet, avec et sans consentement ;
vérification des paramètres envoyés à chaque plateforme (valeur, devise, identifiant de transaction, données utilisateur hachées) ;
contrôle de la déduplication entre pixel navigateur et API de conversion ;
vérification dans les interfaces des plateformes elles-mêmes, pas seulement dans l'aperçu GTM.
Ce dernier point est important : une balise qui se déclenche dans l'aperçu ne prouve pas que la plateforme a reçu et accepté la donnée. Pour structurer cet audit, vous pouvez reprendre notre checklist d'audit de tracking en 15 points.
Et après chaque mise en production du site
Ajoutez une règle simple dans le processus de l'agence web : après chaque déploiement touchant un gabarit, le tunnel de commande ou la bannière cookies, un test rapide des conversions principales. Dix minutes de test évitent des semaines de données perdues.
Pourquoi la surveillance est-elle aussi une question de conformité LPD et RGPD ?
La surveillance n'est pas qu'une affaire de performance. Une mise à jour peut aussi rendre votre site non conforme à ce que vous affichez.
Exemple fréquent : après un changement de CMP ou de thème, l'état de consentement par défaut n'est plus défini avant les balises. Des requêtes partent vers des plateformes publicitaires alors que le visiteur n'a encore rien choisi. Votre politique de confidentialité promet l'inverse.
L'art. 7 LPD impose au responsable du traitement de mettre en place des mesures techniques et organisationnelles dès la conception du traitement, et de garantir par des préréglages appropriés que le traitement soit limité au minimum requis par la finalité. Une surveillance régulière du comportement réel des balises fait partie de ces mesures : elle permet de démontrer que ce qui est annoncé correspond à ce qui se passe. Pour vos visiteurs situés dans l'Union européenne, le RGPD pose des exigences comparables, et le PFPDT comme les autorités européennes regardent ce que fait réellement le site, pas seulement ce que dit la bannière.
Nous ne vous conseillons pas de transformer chaque alerte en dossier juridique. Mais un journal simple des contrôles effectués (date, parcours testés, anomalies corrigées) est un document utile le jour où un client, un auditeur ou le PFPDT pose des questions. Notre article de fond sur le tracking server-side rappelle pourquoi cette architecture facilite justement ce contrôle.
À quoi ressemble une panne dans une PME suisse ?
Voici un scénario type, fictif mais construit à partir des situations que nous rencontrons le plus souvent en audit.
Une boutique en ligne vaudoise de produits du terroir change de thème un jeudi soir. Le nouveau thème réécrit la page de confirmation de commande. Le snippet GTM est toujours présent dans l'en-tête, mais le bloc qui poussait l'événement purchase dans le dataLayer n'a pas été repris.
Sans surveillance : les pages vues arrivent normalement, les rapports de trafic sont rassurants. Les campagnes Google Ads et Meta continuent de dépenser. Deux ou trois semaines plus tard, quelqu'un remarque que le ROAS s'est effondré. Il faut encore plusieurs jours pour trouver la cause, et l'historique de conversions de la période est perdu pour les algorithmes.
Avec surveillance : dès le vendredi, l'alerte quotidienne signale zéro achat mesuré alors que la boutique a enregistré des commandes. Le correctif est déployé le jour même. L'impact se limite à une journée.
La différence ne tient pas à la technologie utilisée, mais à l'existence d'un contrôle et d'une personne qui le lit.
Qui doit surveiller : l'agence web, l'agence marketing ou l'entreprise ?
C'est souvent là que tout se joue. Chacun pense que l'autre surveille. Nous recommandons un partage clair des rôles.
L'agence web prévient avant chaque déploiement touchant les gabarits, le tunnel de commande ou la CMP, et teste les conversions principales après la mise en production.
L'agence marketing suit les conversions dans les plateformes publicitaires et signale toute baisse inexpliquée, sans modifier elle-même le conteneur serveur.
Le responsable tracking (interne ou externe) reçoit les alertes, lit les logs chaque semaine, réalise l'audit périodique et tient le journal des contrôles.
L'entreprise désigne un propriétaire des accès (GTM, hébergement sGTM, plateformes) et valide les changements de CMP ou de politique de confidentialité.
Pour une agence, formaliser ce partage est aussi un argument commercial : vous vendez une mesure fiable dans le temps, pas une installation ponctuelle.
Comment A-Track peut vous aider
Nous accompagnons les PME, les agences web et les agences marketing en Suisse sur l'ensemble du cycle.
Mise en place : architecture server-side, CMP, Consent Mode et connexions API, avec notre service Tracking & Conformité.
Surveillance et maintenance : alertes calibrées, revue des logs, audits périodiques, veille technique et réglementaire, avec notre service Maintenance Annuelle.
Pour les agences : nous intervenons en marque blanche ou en appui de vos équipes, pour que vos clients gardent des données fiables sans que votre équipe y passe ses semaines.
Conclusion : la mise en ligne n'est que le début
Un tracking server-side bien construit reste l'une des meilleures décisions que vous puissiez prendre pour vos données marketing. Mais sa valeur dépend de sa fiabilité dans le temps. Les pannes les plus coûteuses ne sont pas les plus spectaculaires : ce sont les coupures partielles, silencieuses, que personne ne voit pendant des semaines.
Votre prochaine étape : vérifiez aujourd'hui si quelqu'un reçoit une alerte quand vos conversions tombent à zéro. Si la réponse est non, commencez par là. Et si vous souhaitez un regard extérieur sur votre configuration actuelle, parlons de votre maintenance.
Sources : Stape, Server-side tracking doesn't stay fixed (2 septembre 2026) ; Stape, CMP not pushing consent update event to dataLayer (9 septembre 2026) ; Google, documentation Consent Mode ; Fedlex, loi fédérale sur la protection des données (LPD, RS 235.1).